
18 November 2026: dua backend PHP di belakang nginx 1.26.3, diperbarui satu per satu. Satu klien mengirim 128 permintaan selama pekerjaan; 128 semuanya kembali 200.
Jangan pernah merawat satu-satunya salinan. Perbarui satu backend, buktikan, baru berikutnya.
- Keluarkan satu backend dari rotasi load balancer.
- Perbarui dan uji sendirian, lalu kembalikan ke layanan.
- Ulangi untuk backend berikutnya; pengunjung tak pernah bertemu situs tertutup.
Berencana berhenti total? Baca dulu aturan SEO di apakah 503 merusak SEO.
Halaman “sedang maintenance” lahir karena seseorang memperbarui satu-satunya salinan.
Dengan dua salinan yang melayani, maintenance berubah jadi rotasi, bukan gangguan.
Tekniknya lama dan membosankan — persis alasan situs besar berani patch di siang hari.
Satu Gagasannya: Selalu Ada Cadangan yang Melayani
Load balancer mengirim setiap permintaan ke satu backend yang sehat.
Keluarkan backend A dari rotasi, dan semua permintaan diam-diam mendarat di backend B.
Perbarui A dengan santai, uji langsung, lalu biarkan ia melayani lagi.
Ulangi dengan B. Pada setiap momen, minimal satu backend terkini tetap hidup.
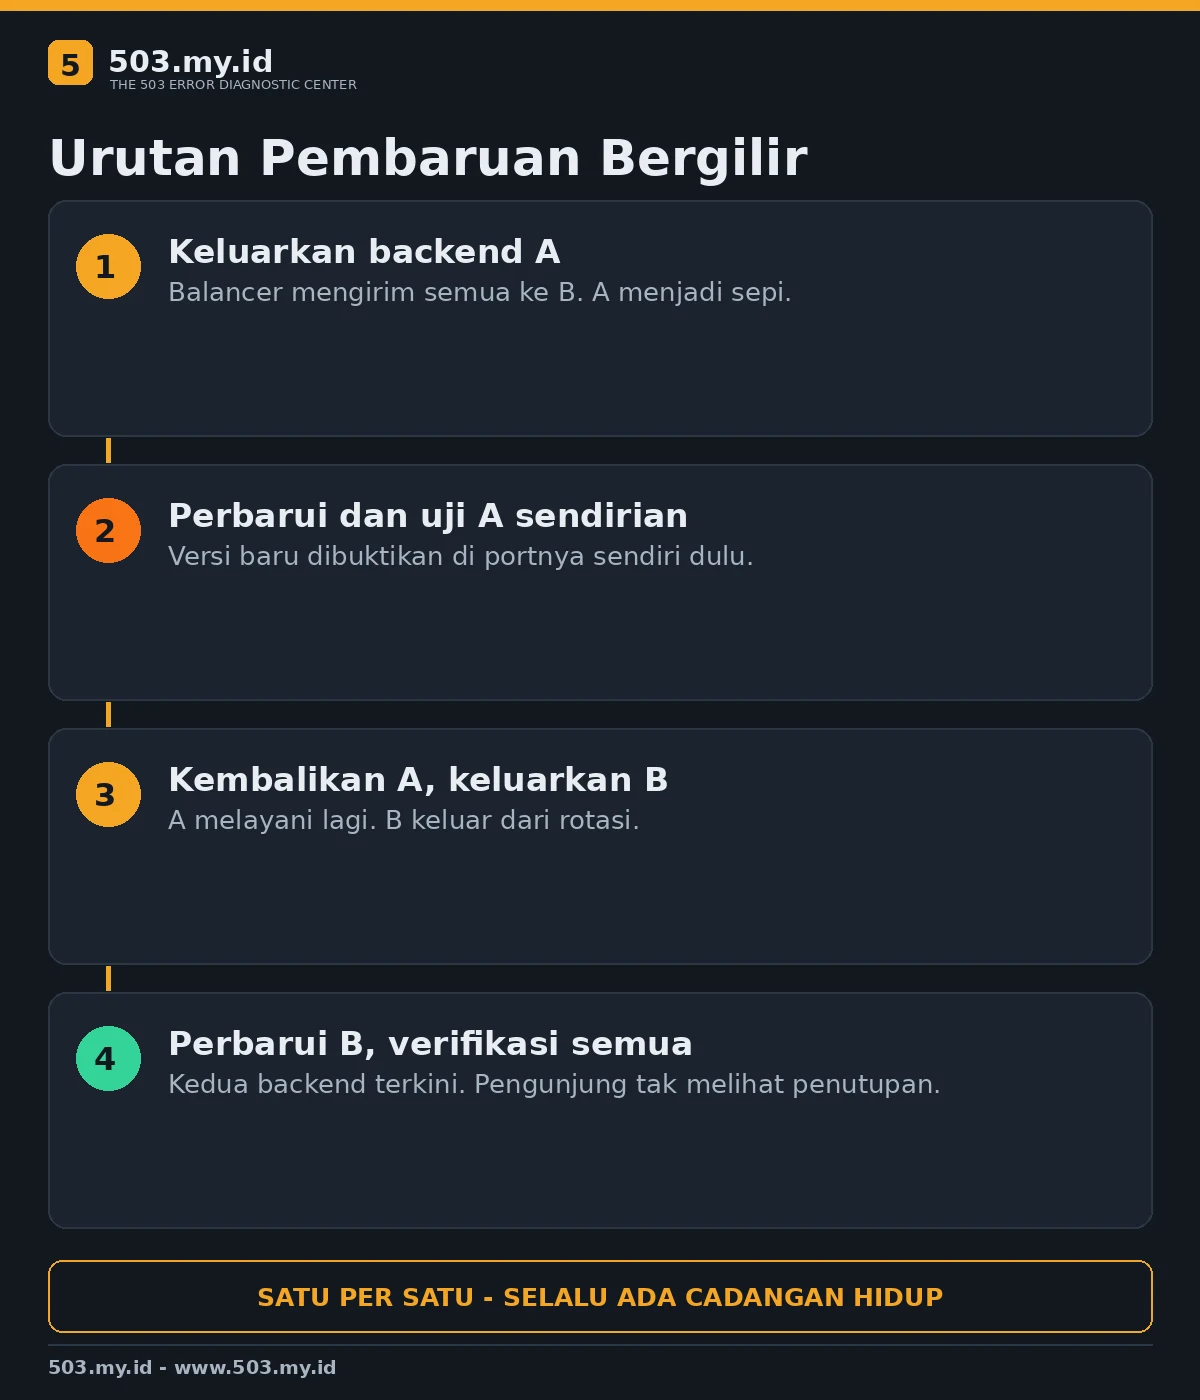
Diagram urutan berikut adalah rotasi persis yang dijalankan lab kami:
Lab Kami: 128 Permintaan, Nol Gagal
nginx 1.26.3 menyeimbangkan dua backend PHP; masing-masing menandai respons dengan nama dan versinya.
Blok upstream yang diuji:
upstream batchb_roll {
    server 127.0.0.1:19001;
    server 127.0.0.1:19002;
}
Satu klien meminta halaman terus-menerus selagi kami mengerjakan rotasinya.
Backend A dikeluarkan, diperbarui dari v1 ke v2, diuji langsung, lalu dikembalikan.
Backend B kemudian menerima perlakuan yang sama.
Log klien selama seluruh operasi:
requests: 128, status counts: {200: 128}
versions seen: backend-a-v1, backend-a-v2, backend-b-v1, backend-b-v2
Kedua versi dari kedua backend terlihat, membuktikan lalu lintas benar-benar mengikuti rotasi.
Tak satu pun permintaan bertemu halaman maintenance, karena memang tak pernah dibutuhkan.
Urutan Bergilirnya, Langkah demi Langkah
- Keluarkan. Komentari atau turunkan bobot backend A; tunggu permintaan aktifnya selesai.
- Buktikan keluarnya. Probe kamu kini hanya boleh melihat cap versi B.
- Perbarui A. Deploy kode, jalankan migrasi yang tetap kompatibel mundur, restart layanan A.
- Uji A langsung. Minta A di portnya sendiri; cek versi, log, dan satu transaksi nyata.
- Kembalikan A. Pulihkan bobotnya; pantau tingkat error beberapa menit.
- Ulangi untuk B. Urutan sama, pemeriksaan sama, tanpa jalan pintas karena A lancar.
Perubahan database adalah tepi tajamnya: kedua versi harus tahan skema di tengah rotasi.
Perluas dulu, migrasikan data kedua, kecilkan terakhir — sesudah semua backend menjalankan kode baru.
Cuma Satu Server? Pilihan Jujurnya
Situs kecil berserver tunggal tidak bisa merotasi sesuatu yang tidak dimilikinya.
Staging di host yang sama tetap menolong: tukar document root, dan downtime menyusut jadi hitungan detik.
Jendela maintenance pada jam tersepimu tetap pilihan yang sah dan jujur.
Kalau seluruh situs harus berhenti, jawab 503 dengan header Retry-After yang masuk akal.
Panduan Google sendiri memperlakukan kombinasi itu sebagai jeda sementara yang dipahami.
Durasi yang tetap aman dipetakan di berapa lama situs boleh down.
Khusus WordPress, sisi perbaikannya dibahas panduan 503 sesudah update.
Yang Tidak Berhasil
Memperbarui kedua backend sekaligus menciptakan kembali gangguan yang hendak dicegah metode ini.
Melewatkan uji langsung pada A akan mengirim versi belum teruji ke separuh lalu lintas.
Perubahan skema yang tak bisa dibaca kode lama merusak B di tengah rotasi pada uji sampingan.
Kegagalan itu alasan urutan perluas–migrasi–kecilkan bukan hiasan pilihan.
Mengumumkan halaman maintenance “untuk jaga-jaga” tidak melatih siapa pun; rotasinya bekerja begitu saja.
Checklist Sebelum Terbang
- Dua backend atau lebih, masing-masing sanggup memikul seluruh lalu lintas sendirian.
- Cap versi atau log yang membuktikan backend mana yang menjawab.
- Migrasi ditinjau untuk kompatibilitas kode lama dan kode baru.
- Salinan rilis sebelumnya siap rollback di setiap backend.
- Monitoring diawasi manusia sampai backend terakhir kembali.
Jadikan kebiasaan ini bagian tetap panduan mencegah error 503.
Dan biarkan pemeriksa 503 gratis kami terbuka selama rotasi.
FAQ
Perlukah dua server fisik?
Tidak. Dua instance aplikasi mandiri di belakang satu balancer sudah memungkinkan rotasinya.
Bagaimana permintaan yang sedang berjalan saat backend dikeluarkan?
Pengeluaran menunggu permintaan aktif; hanya permintaan baru yang pindah ke backend lain.
Bisakah ini di shared hosting?
Tidak sepenuhnya — salinanmu cuma satu. Pakai tukar staging dan jendela maintenance singkat yang jujur.
Apakah Google menghukum pembaruan bergilir?
Pengunjung dan crawler hanya melihat 200, jadi tidak ada yang perlu dihukum.
Sumber dan tanggal: dokumentasi upstream NGINX, panduan Google Search Central, dan uji lab kami, diperiksa 18 November 2026.
References
- Google Search Central — How to pause your online business on Google Search
- Google Search Central Blog — How to deal with planned site downtime
- NGINX Documentation — Module ngx_http_proxy_module (upstream servers)
- RFC 9110 §14.3 — Retry-After
Leave a Reply